ACSAC 2026À paraître
TRACER
Un agent qui apprend à repérer des cyberattaques qu'il n'a jamais vues, même quand personne ne lui dit s'il a raison.
Le problème
Un système de détection d'intrusion (IDS) surveille le trafic d'un réseau et lève une alerte quand quelque chose ressemble à une attaque. Les IDS modernes s'appuient pour beaucoup sur des algorithmes de Machine et Deep Learning : on leur montre des exemples de trafic normal et d'attaques, et ils apprennent à les différencier.
Cette approche, dite supervisée, n'est que l'application de techniques très performantes dans d'autres domaines. Cependant, pour la détection d'anomalie, elle souffre de deux limites :
- Les attaques inconnues. Un modèle reconnaît bien ce qu'il a vu à l'entraînement, beaucoup moins une nouvelle typologie d'attaque (une nouvelle classe). On parle d'attaque zero-day.
- Le trafic change. Nouveaux équipements, nouvelles applications, nouveaux usages : même le trafic normal évolue avec le temps. Les performances du modèle se dégradent, et il faut le réentraîner régulièrement avec des données fraîchement étiquetées par des experts. C'est long et coûteux.
L'idée : un agent qui apprend en continu
TRACER repose sur l'apprentissage par renforcement. Au lieu d'apprendre une fois lors de l'entrainement, un agent prend une décision pour chaque flux réseau, reçoit une récompense si elle est bonne ou une pénalité si elle est mauvaise, et ajuste son comportement au fil de l'eau : il s'entraîne continuellement.
- 01Flux réseauUne connexion arrive, décrite par ses caractéristiques.
- 02AgentIl observe le flux.
- 03DécisionTrafic normal, ou alerte ?
- 04RécompensePositive si la décision était bonne, négative sinon.
↺ L'agent ajuste sa stratégie, puis passe au flux suivant
Tout repose sur la récompense qui guide l'apprentissage de l'agent. Or, dans la plupart des travaux, celle-ci est calculée à partir de la vérité terrain (le label). Dans un réseau réel, ce label est inconnu pour le trafic réseau, et d'autant plus pour une zero-day.
Une récompense à deux visages
TRACER choisit sa façon de récompenser l'agent selon ce qu'il sait du flux.
Connaît-on la bonne réponse pour ce flux ?
Récompense classique
On compare la décision de l'agent au label. La confiance est maximale car on s'appuit sur la vérité terrain.
Récompense par vote
Trois algorithmes de clustering donnent leur avis sur le flux. La majorité l'emporte, et la récompense est d'autant plus forte que les algorithmes sont sûrs d'eux.
Le second chemin est le cœur de notre contribution. TRACER garde en mémoire un échantillon de trafic dont il est sûr qu'il est bénin. Pour juger un nouveau flux, il clusterise une fenêtre du flux courant, avec l'échantillon et les flux bénins, de trois manières différentes (Fuzzy C-Means, Fuzzy DBSCAN et Fuzzy HDBSCAN). Chaque algorithme vote :
- « normal » si le flux tombe dans un groupe composé en majorité de trafic normal connu, et s'il appartient nettement à ce groupe (on voit ce que ça veut dire juste après).
- « alerte » dans tous les autres cas.
Ces algorithmes sont dits flous : ils ne disent pas seulement à quel groupe appartient un flux, mais à quel point il y appartient (un degré d'appartenance entre 0 et 1). Si un point est au centre du cluster, son degré d'appartenance sera proche de 1 ; s'il est à la frontière entre deux cluster, son degré d'appartenance sera faible. Nous utilisons ce degré comme mesure de confiance : un vote hésitant donne une petite récompense, un vote franc une grande. L'agent n'est donc jamais fortement puni ou récompensé sur la base d'un avis incertain.
Utiliser trois algorithmes plutôt qu'un n'est pas un luxe : chacun voit le trafic sous un angle différent, et aucun n'est fiable seul sur tous les réseaux.
Essayez vous-même
Réglez l'avis de chaque algorithme et la décision de l'agent : la récompense est calculée comme dans le papier.
Fuzzy C-Means
Vote : normal
Fuzzy DBSCAN
Vote : alerte
Fuzzy HDBSCAN
Vote : alerte
Un algorithme vote « normal » si le groupe est surtout normal et si le degré d'appartenance dépasse 0,3. La confiance est le degré moyen des algorithmes de la majorité ; la récompense vaut ±(1 + confiance) / 2.
Comment on l'a évalué
TRACER est évalué sur quatre jeux de données de référence (NSL-KDD, CICIDS17, UNSW-NB15 et ToN-IoT), avec exactement les mêmes réglages. Le clustering n'est pas très bon en haute dimensions, c'est pourquoi nous avons réduit les dimensions avec PCA, SCARF, et un autoencodeur afin de travailler dans des espaces de plus petites dimensions. L'évaluation est réalisée dans deux scénarios réalistes :
- L'attaque zero-day On retire entièrement une famille d'attaques de l'entraînement, puis on la fait apparaître dans un second temps. On recommence pour chacune des 23 familles. C'est plus exigeant que beaucoup de travaux, où le « zero-day » n'est qu'une variante d'une attaque déjà connue. TRACER apprend en se basant sur les étiquettes sur le trafic connu, et bascule sur la récompense par vote pour le trafic inconnu - dont l'attaque zero-day.
- Les étiquettes manquantes. On masque progressivement les labels, de 0 % à 100 %, pour voir jusqu'où l'agent tient.
La performance est mesurée par un score de détection : il n'est élevé que si l'agent reconnaît à la fois l'attaque et le trafic normal. Un système qui lève une alerte en permanence obtient un mauvais score.
Résultats : face à des attaques jamais vues
Les deux références sont des méthodes classiques entraînées uniquement sur du trafic normal. TRACER est ici utilisé avec la représentation PCA.
Le score de détection tourne souvent autour de 80 % et dépasse 90 % pour plusieurs familles d'attaques, tout en gardant un bon niveau sur les attaques déjà connues : apprendre du nouveau ne fait pas oublier l'ancien, on évite le catastrophic forgetting.
Deux résultats ressortent :
- Les attaques rares sont détectées. L'attaque Man-in-the-Middle de ToN-IoT (78,9 %), Shellcode dans UNSW-NB15 (81,5 %) et U2R dans NSL-KDD (78,5 %) représentent chacune moins de 2 % des données.
- La récompense basée sur le vote fait parfois mieux que le supervisé. Sur certaines attaques (Exploits et Backdoor dans UNSW-NB15, U2R dans NSL-KDD), TRACER dépasse un agent récompensé avec les vraies étiquettes.
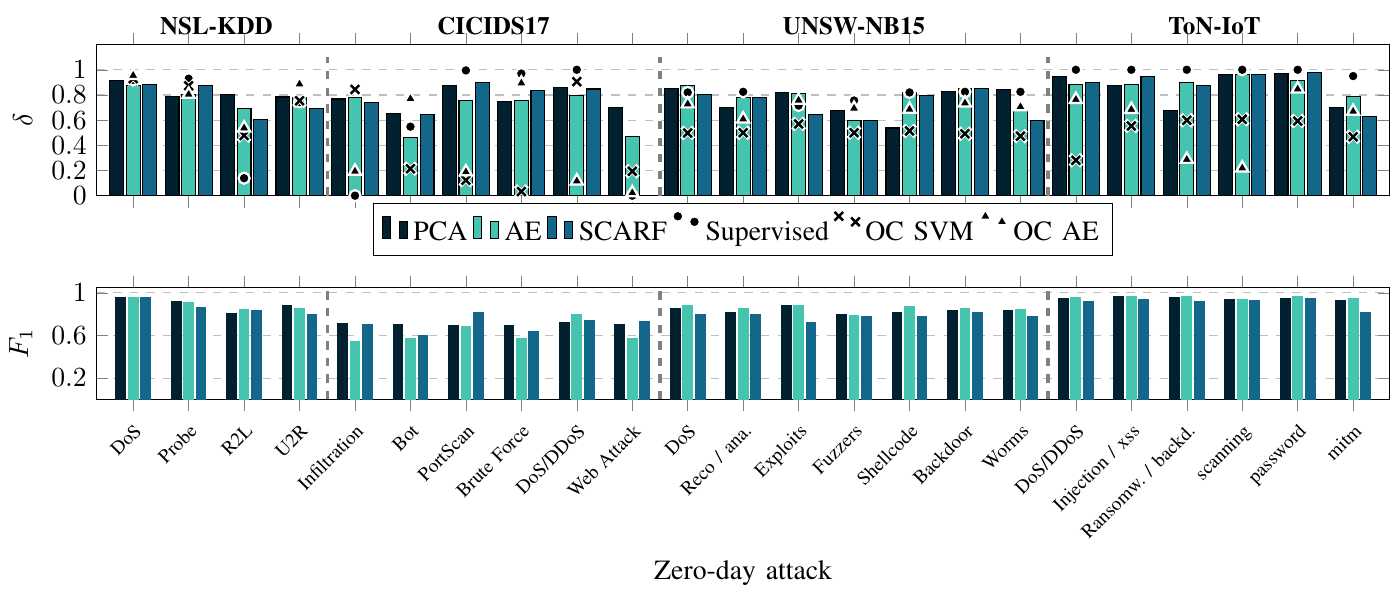
Explorez les résultats attaque par attaque
Rappel : quelle part des flux de l'attaque jamais vue TRACER repère-t-il ?
Il apprend vite
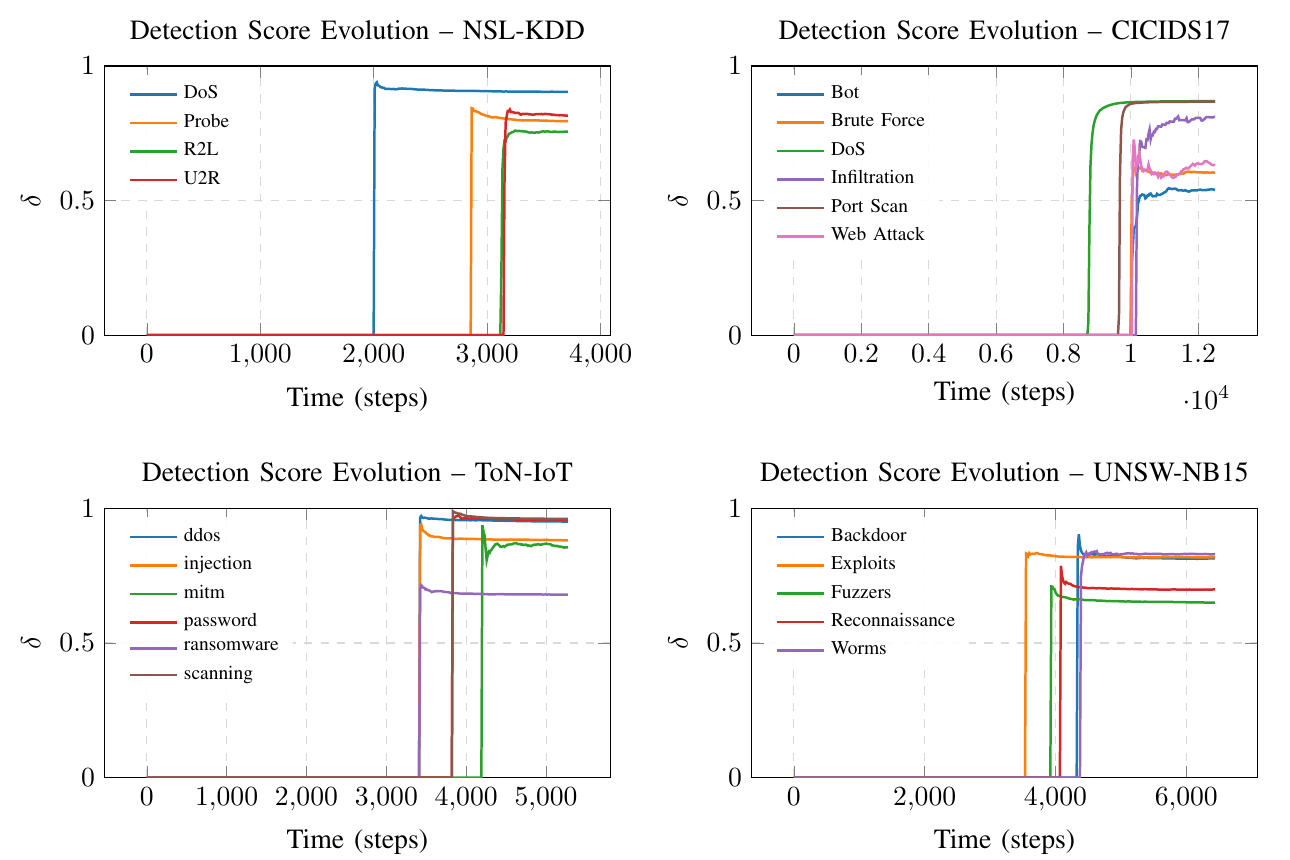
Dès que les premiers flux d'une nouvelle attaque apparaissent, le score grimpe presque à la verticale : pour la majorité des attaques, il atteint 90 % de sa valeur finale en quelques dizaines d'étapes. C'est essentiel pour un zero-day, où l'on ne dispose que de quelques exemples avant de devoir réagir.
Résultats : quand les étiquettes manquent
Les performances restent stables jusqu'à environ 70 % d'étiquettes masquées, puis chutent. Autrement dit, une petite fraction de données étiquetées suffit à « amorcer » l'agent, le vote prend ensuite le relais. Avec seulement 30 % d'étiquettes, le score global reste autour de 80 % sur la plupart des jeux de données.
Plus simple qu'on ne le pensait
L'apprentissage par renforcement est conçu pour des situations où chaque décision influence les états qui suivent, comme une partie d'échecs. Ici ce n'est pas le cas : lever une alerte et classer un flux ne change rien au flux suivant. Le problème se ramène alors à une forme beaucoup plus simple, le bandit contextuel, où seule la récompense immédiate compte : la complexité est moindre et la convergence plus rapide.
Le papier le démontre puis le vérifie : un agent « bandit » léger obtient des performances comparables à l'agent d'apprentissage par renforcement profond sur la plupart des attaques, pour un temps d'entraînement presque divisé par deux.
Sur le terrain
TRACER est pensé pour tourner au plus près du réseau, sur du matériel courant. Il a été déployé sur l'infrastructure d'un partenaire industriel, où il a été mesuré avec du trafic rejoué à partir des quatre jeux de données.
En parallèle, une copie de l'agent continue d'apprendre en arrière-plan : remplacer l'agent en service par sa version à jour prend moins de 0,04 ms. La charge processeur reste autour de 23 % et la mémoire autour de 1,3 %.
Limites et suite
TRACER n'est pas infaillible. Quand une attaque ressemble trop au trafic normal, comme c'est le cas de Web Attack, Bot et Infiltration dans CICIDS17, les algorithmes de clustering ne parviennent pas à la séparer, et l'agent lève trop de fausses alertes. C'est une limite pour un système qui n'observe que des statistiques de flux, sans leur contenu.
Les prochaines étapes :
- combiner plusieurs représentations des données, puisque chacune révèle des attaques différentes : on étudie de nouveaux espaces latents grâce à d'autres techniques de réduction de dimensions.
- pondérer les trois algorithmes selon le réseau surveillé et les attaques ciblées.
- étudier les dérives progressives du trafic : l'apparition de zero-day est vu comme un concept drift soudain, mais le trafic peut aussi évoluer de manière plus graduelle.
- brancher le TRACER sur du trafic réel de production.
À retenir
- TRACER peut continuer d'apprendre sans étiquettes grâce à notre fonction de récompense basée sur l'ensemble clustering.
- Cette approche détecte des familles d'attaques entièrement nouvelles, y compris rares, sans dégrader la détection des attaques connues. Cependant, certaines attaques passent encore à travers les mailles du filet et sont absorbés par les clusters de flux bénins.
- Pour la détection d'intrusion levant des alertes (IDS), le "contextual bandit" suffit. Le DRL serait sans doute plus adapté lorsque l'agent peut agir sur le réseau (IPS).